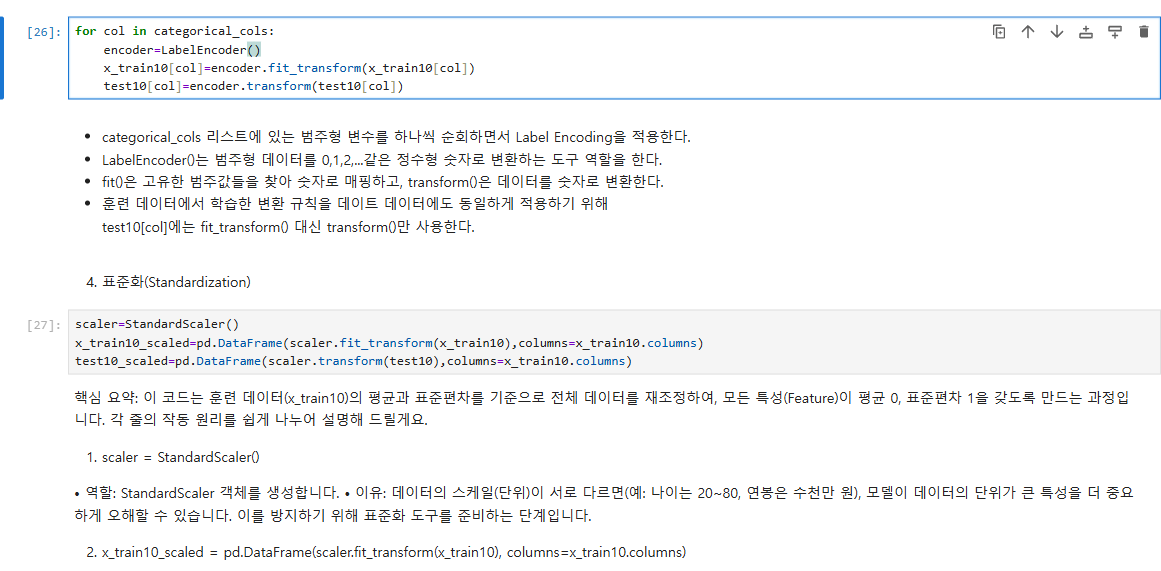
답변함 표준화 문제 kjh2927 2026년 10월 25일 04:18 공유 기출문제 1에서 표준화시 반드시 숫자 컬럼만 해야한다고 들었는데.. 기출문제 2에서는 표준화시 숫자 컬럼만 구분하여 하지 않아도 되는지..? 그 차이를 설명해 주시기 바랍니다!! 0 댓글 댓글 2개 정렬 기준 날짜 투표수 kjh2927 2026년 10월 25일 04:27 추가로 표준화시 x_train10과 test10의 컬럼을 동일하게 지정(columns=x_train10.columns)한 것에 대해서도 설명을 부탁드립니다. 0 emhu8640 2026년 10월 25일 09:03 교수님 질문하신 내용에 대한 답변입니다.핵심: 표준화할 때 컬럼이 숫자형이어야 하는 것은 같습니다. 차이는 표준화하기 전에 범주형 컬럼이 이미 숫자로 바뀌어 있었느냐입니다.기출문제 1: 숫자 컬럼만 골라야 하는 경우 범주형 컬럼이 아직 문자(‘male’, ‘S’ 등)로 남아 있는 상태에서 표준화하는 경우입니다. StandardScaler는 평균과 표준편차를 계산해야 하므로 문자가 섞여 있으면 오류가 납니다. 그래서 숫자 컬럼만 골라서 표준화해야 합니다. 기출문제 2: 전체를 표준화해도 돌아가는 경우 [26]번 셀에서 LabelEncoder로 범주형 컬럼을 이미 0, 1, 2… 정수로 바꿨습니다. 그래서 [27]번 셀 시점에는 모든 컬럼이 숫자이고, 전체를 넣어도 오류 없이 실행됩니다. 추가질문에 대한 답변입니다.Q. test10에도 columns=x_train10.columns를 쓰는 이유는? 컬럼 이름 복원: scaler.transform()의 결과는 컬럼 이름이 없는 NumPy 배열이라 이름을 다시 붙여야 합니다. 학습 데이터와 같은 구조: 스케일러와 모델은 x_train10의 컬럼 순서대로 학습했으므로, test10도 같은 컬럼 이름과 순서를 가져야 예측에 문제가 없습니다. 두 데이터의 컬럼이 같다면 test10.columns를 써도 결과는 같습니다. 0 댓글을 남기려면 로그인하세요. 원하는 것을 찾지 못하셨나요? 질문하기

댓글
추가로 표준화시 x_train10과 test10의 컬럼을 동일하게 지정(columns=x_train10.columns)한 것에 대해서도 설명을 부탁드립니다.
질문하신 내용에 대한 답변입니다.
핵심: 표준화할 때 컬럼이 숫자형이어야 하는 것은 같습니다. 차이는 표준화하기 전에 범주형 컬럼이 이미 숫자로 바뀌어 있었느냐입니다.
기출문제 1: 숫자 컬럼만 골라야 하는 경우
StandardScaler는 평균과 표준편차를 계산해야 하므로 문자가 섞여 있으면 오류가 납니다.기출문제 2: 전체를 표준화해도 돌아가는 경우
추가질문에 대한 답변입니다.
Q. test10에도 columns=x_train10.columns를 쓰는 이유는?
scaler.transform()의 결과는 컬럼 이름이 없는 NumPy 배열이라 이름을 다시 붙여야 합니다.댓글을 남기려면 로그인하세요.