빅분기 작업형 2는 일반적으로 어떤 컬럼을 삭제하라고 지정해 주지 않습니다. 수험자가 판단해야 합니다. 다만 문제마다 다를 수 있으니, 문제에 지시가 있으면 그것을 따릅니다. 판단 기준은 다음 다섯 가지입니다.
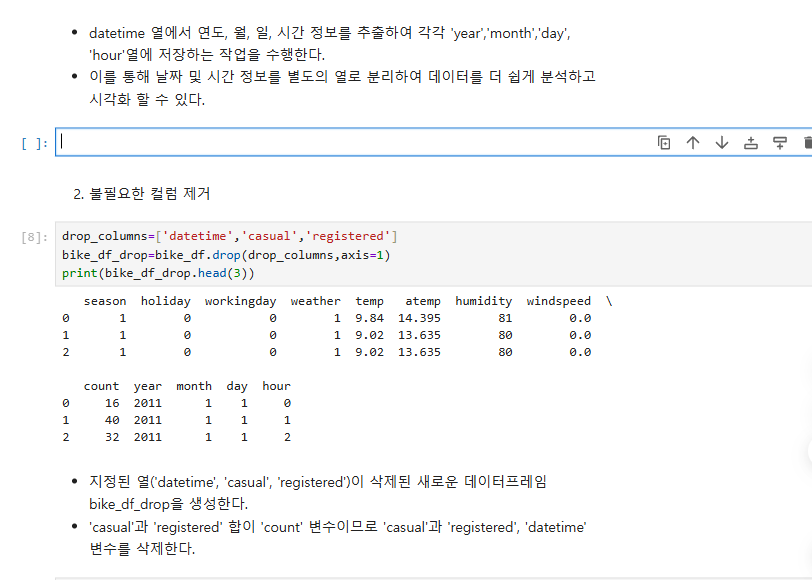
1. 정답(target)을 그대로 알려 주는 컬럼: 반드시 삭제 casual(비회원 대여 수) + registered(회원 대여 수) = count(전체 대여 수)입니다. 이 두 컬럼을 남기면 모델이 더하기만 해서 정답을 맞히는 데이터 누수가 생깁니다. 게다가 이런 컬럼은 test 데이터에는 없는 경우가 많습니다(이 bike 데이터도 test에는 casual, registered가 없음).
2. 이미 분해해서 쓴 원본 컬럼: 삭제 datetime은 year, month, day, hour로 나눴으므로 정보가 중복됩니다. 또 날짜 문자열은 그대로 모델에 넣을 수 없습니다.
3. 식별자: 삭제 ID, 이름, 고유번호처럼 행마다 값이 다른 컬럼은 예측에 쓸 정보가 없고 과적합만 일으킵니다.
4. test 데이터에 없는 컬럼: 삭제 train과 test의 컬럼을 비교해서, train에만 있는 컬럼(target 제외)은 지웁니다. 예측할 때 쓸 수 없기 때문입니다.

댓글
질문에 답변드립니다.
답변: 컬럼 삭제 기준
빅분기 작업형 2는 일반적으로 어떤 컬럼을 삭제하라고 지정해 주지 않습니다. 수험자가 판단해야 합니다. 다만 문제마다 다를 수 있으니, 문제에 지시가 있으면 그것을 따릅니다. 판단 기준은 다음 다섯 가지입니다.
1. 정답(target)을 그대로 알려 주는 컬럼: 반드시 삭제
casual(비회원 대여 수) + registered(회원 대여 수) = count(전체 대여 수)입니다. 이 두 컬럼을 남기면 모델이 더하기만 해서 정답을 맞히는 데이터 누수가 생깁니다. 게다가 이런 컬럼은 test 데이터에는 없는 경우가 많습니다(이 bike 데이터도 test에는 casual, registered가 없음).
2. 이미 분해해서 쓴 원본 컬럼: 삭제
datetime은 year, month, day, hour로 나눴으므로 정보가 중복됩니다. 또 날짜 문자열은 그대로 모델에 넣을 수 없습니다.
3. 식별자: 삭제
ID, 이름, 고유번호처럼 행마다 값이 다른 컬럼은 예측에 쓸 정보가 없고 과적합만 일으킵니다.
4. test 데이터에 없는 컬럼: 삭제
train과 test의 컬럼을 비교해서, train에만 있는 컬럼(target 제외)은 지웁니다. 예측할 때 쓸 수 없기 때문입니다.
빅분기 실기 시험은 2유형는 성능으로만 평가합니다.
댓글을 남기려면 로그인하세요.