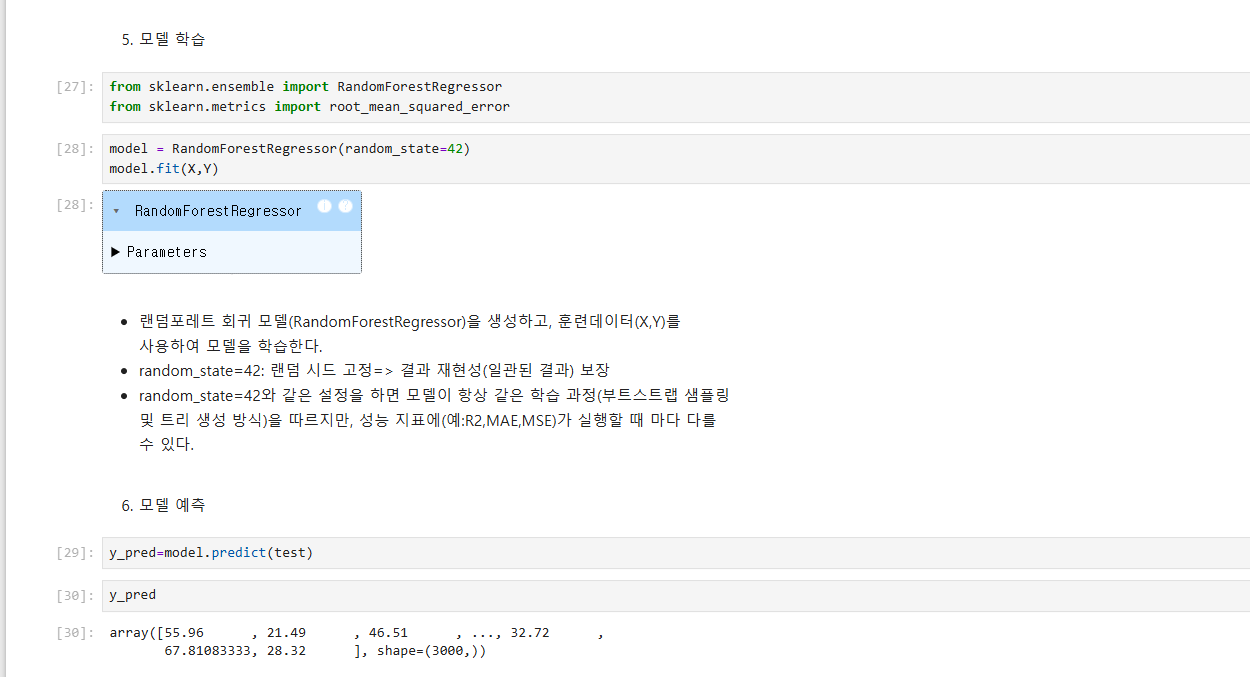
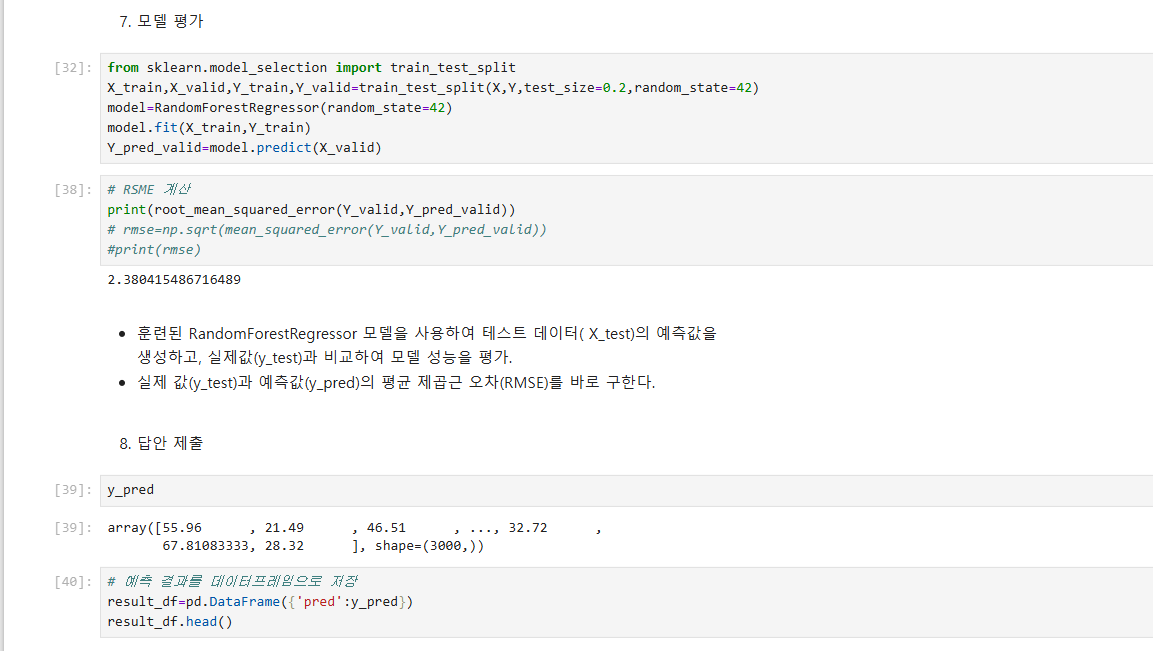
1. 모델 학습을 두 번 하는 목적 두 번의 학습은 목적이 다릅니다. test 데이터에는 정답(Y)이 없어서, 제출할 예측값이 얼마나 정확한지 직접 계산할 수 없습니다. 그래서 정답이 있는 훈련 데이터의 일부(20%)를 떼어 내 검증용으로 쓰고, 그 성능을 test 데이터에서의 성능을 추정하는 기준으로 삼습니다.
2.결과가 같아 보이는데 분할이 필요한가 분할이 필요한 이유는 '평가' 때문입니다: 분할하지 않고 학습에 쓴 데이터로 RMSE를 계산하면, 모델이 이미 본 데이터라서 실제보다 훨씬 좋게 나옵니다. 랜덤포레스트는 특히 훈련 데이터에 잘 맞기 때문에 이 차이가 큽니다. 학습에 쓰지 않은 검증 데이터로 계산한 RMSE(2.38)가 처음 보는 데이터에서의 성능을 더 정확하게 보여 줍니다
일반적인 순서: ① 분할 → ② 훈련용으로 학습 → ③ 검증용으로 평가 → ④ (선택) 전체 데이터로 다시 학습 → ⑤ test 예측·제출. 교재는 ④⑤를 먼저 하고 ①~③을 나중에 보여 준 순서라서 헷갈리셨을 수 있습니다. 시험에서는 ①~③으로 성능을 확인한 모델로 바로 test를 예측해 제출해도 됩니다.
3. 시험 환경에서 복사·붙여넣기 가능 여부 활용하실수 없습니다. 메모장에서는 복붙이 가능합니다. 마우스로 개별적 복붙은 가능하지만 전체 블록 복붙은 불가합니다. 참고하세요

댓글
안녕하세요 질의하신 내용에 대한 답변입니다.
1. 모델 학습을 두 번 하는 목적 두 번의 학습은 목적이 다릅니다.
test 데이터에는 정답(Y)이 없어서, 제출할 예측값이 얼마나 정확한지 직접 계산할 수 없습니다.
그래서 정답이 있는 훈련 데이터의 일부(20%)를 떼어 내 검증용으로 쓰고,
그 성능을 test 데이터에서의 성능을 추정하는 기준으로 삼습니다.
2.결과가 같아 보이는데 분할이 필요한가
분할이 필요한 이유는 '평가' 때문입니다: 분할하지 않고 학습에 쓴 데이터로 RMSE를 계산하면,
모델이 이미 본 데이터라서 실제보다 훨씬 좋게 나옵니다. 랜덤포레스트는
특히 훈련 데이터에 잘 맞기 때문에 이 차이가 큽니다. 학습에 쓰지 않은 검증 데이터로 계산한 RMSE(2.38)가 처음 보는 데이터에서의 성능을 더 정확하게 보여 줍니다
일반적인 순서: ① 분할 → ② 훈련용으로 학습 → ③ 검증용으로 평가 → ④ (선택) 전체 데이터로 다시 학습 →
⑤ test 예측·제출. 교재는 ④⑤를 먼저 하고 ①~③을 나중에 보여 준 순서라서 헷갈리셨을 수 있습니다.
시험에서는 ①~③으로 성능을 확인한 모델로 바로 test를 예측해 제출해도 됩니다.
3. 시험 환경에서 복사·붙여넣기 가능 여부
활용하실수 없습니다. 메모장에서는 복붙이 가능합니다.
마우스로 개별적 복붙은 가능하지만 전체 블록 복붙은 불가합니다. 참고하세요
댓글을 남기려면 로그인하세요.